ColPali Modelinin Türkçe Bilgi Erişimi İçin İnce Ayar (Fine-Tuning) ile Uyarlanması
Natural Language Processing • Information Retrieval • Transformer Fine-Tuning
Bu projede, sorguya bağlı bilgi erişimi için geliştirilmiş dönüştürücü tabanlı ColPali modeli, Türkçe diline özel bir veri seti kullanılarak ince ayar (fine-tuning) yöntemiyle yeniden eğitilmiştir. Amaç, Türkçe sorgular ile ilgili ve ilgisiz pasajları yüksek doğrulukla ayırt edebilen bir bilgi erişim modeli geliştirmektir.
Problem Tanımı
Önceden eğitilmiş dil modelleri, İngilizce odaklı veri setlerinde yüksek başarı gösterirken, Türkçe gibi dillerde bilgi erişimi görevlerinde sınırlı performans sunmaktadır. Bu çalışmada, ColPali modelinin Türkçe’ye özgü, alan odaklı bir veri seti ile ince ayar yapılarak ilgili/ilgisiz pasaj ayrımında ne düzeyde başarılı olduğu incelenmiştir.
Ne Yaptım?
- ColPali modelini Türkçe bilgi erişimi görevine uygun olacak şekilde fine-tune ettim
- Triplet yapıdaki (sorgu–pozitif–negatif pasaj) verileri ikili sınıflandırmaya dönüştürdüm
- HuggingFace Trainer API kullanarak hızlı ve kontrollü bir eğitim süreci yürüttüm
- Modeli Accuracy, Precision, Recall, F1, ROC-AUC ve MRR metrikleri ile değerlendirdim
- ROC, PR eğrileri, Confusion Matrix ve embedding görselleştirmeleri oluşturdum
Model Performansı
Eğitim sonucunda model; %99.4 doğruluk, 0.9997 MRR ve yüksek recall değerleri elde etmiştir. ROC ve Precision–Recall eğrileri, modelin ilgili ve ilgisiz pasajları güçlü bir şekilde ayırt edebildiğini göstermektedir.
Görsel Analizler
Modelin öğrenme davranışı, sınıflandırma başarısı ve sorgu–pasaj temsil yapısı aşağıdaki görsellerle özetlenmiştir.
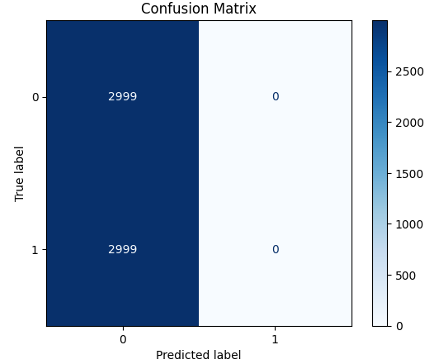
Confusion Matrix (Karışıklık Matrisi):
Modelin “ilgili” ve “ilgisiz” örnekleri ne kadar doğru ayırdığını gösterir.
Diyagonal hücrelerin yüksek olması, doğru sınıflandırmanın güçlü olduğunu ifade eder.
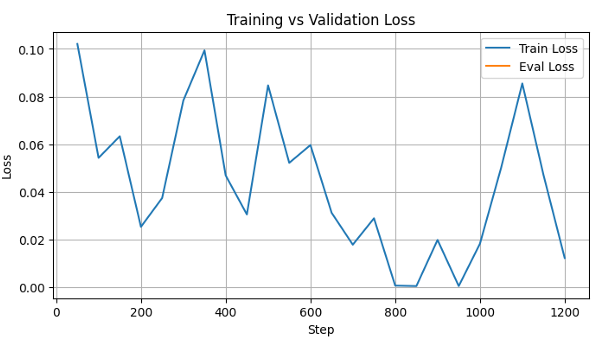
Training vs Validation Loss:
Eğitim (train) ve doğrulama (validation) kayıp değerlerinin adım (step) boyunca değişimini gösterir.
İki eğrinin birlikte düşmesi, modelin genelleme performansının iyi ilerlediğine işaret eder.
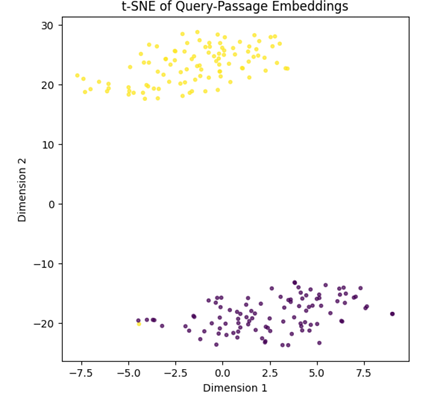
t-SNE (Sorgu–Pasaj Embedding Dağılımı):
Sorgu ve pasaj temsillerinin (embedding) 2 boyutta görselleştirilmiş halidir.
Kümelerin ayrışması, modelin “ilgili” ve “ilgisiz” içerikleri temsil uzayında
anlamlı şekilde ayırabildiğini gösterir.
Kullanılan Teknolojiler
Python • HuggingFace Transformers • BERTurk • Google Colab (GPU) • ROC / PR Analysis • t-SNE / PCA
Kaynak Kod
Projeye ait kaynak kodlar, deneysel çalışma ve akademik bütünlük nedeniyle özel (private) bir GitHub deposunda tutulmaktadır.
Private GitHub RepositoryProje Dokümanı (PDF)
Projeye ait detaylı açıklamalar, yöntemler ve deneysel sonuçlar aşağıdaki dokümanda sunulmaktadır.
PDF’i Yeni Sekmede Aç